

有 Trace 以后,排查可以先收窄到具体层:是 Plan 走偏、State 没更新、Context 携带了错误信息,还是模型、Tool、Middleware、数据或 SubAgent 出了问题?图里把这些可能性拆开,便于按证据排除。
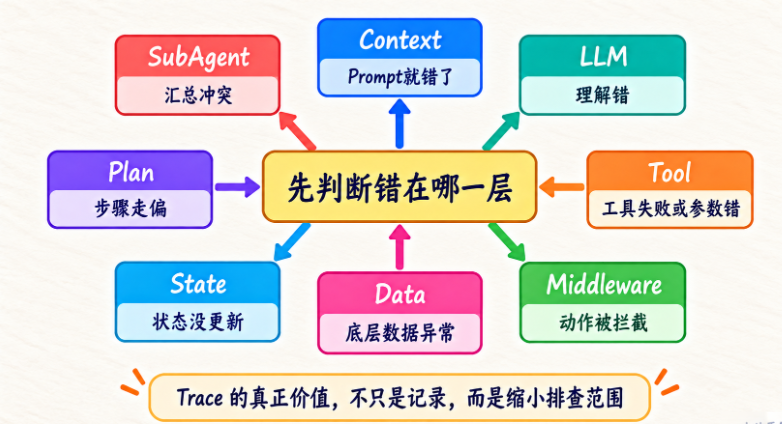
它不是说一张图就能自动判定根因,而是提醒我们先找对应的 Prompt、Tool Result、状态事件与执行记录,别只看最终答案就直接归咎于模型。
有了 Trace 以后,真正有价值的是,定位问题属于哪一层。
一个 Agent 失败,大致可能来自:
Context
LLM
Tool
Middleware
Data
State
Plan
SubAgent
情况一:Prompt 就错了
Trace 里发现:
AGENTS.md 没加载于是模型修改了 tests/。
这不是模型一定不听话。
而是:
ContextBuilder 没把规则送进去。情况二:模型选择错 Tool
Prompt 正确。
但模型:
应该 read_file
却选择 write_file
这是:
LLM Decision Error。情况三:Tool 选对,参数错
例如:
read_file对。
但:
path = "tests/app.py"错。
这是:
Argument Error。情况四:Tool 本身失败
例如:
run_shell("pytest -q")参数对。
但环境:
pytest not found参数对。
但环境:
pytest not found这是:
Environment / Tool Error。情况五:Tool Result 正确,但模型解释错
Data Analysis 最常见。
SQL 返回:
eCPM -35%模型却总结:
请求量下降。这是:
Interpretation Error。情况六:Middleware 拦截关键动作
例如:
delete_file被拒绝。
任务随后无法继续。
这不是 Tool Failure。
而是:
Policy Decision。Trace 必须能看出来。
情况七:SubAgent 汇总冲突
Code Agent:
根因 ATest Agent:
失败仍在 BMain Agent 直接选择 A。
这是:
Orchestration Error。这就是 Trace 真正强大的地方。
它把“Agent 错了”拆成:
到底哪一层错了。让 Trace 还原当时发生的事
一次模型响应可能请求两个工具。若我们为每个工具都记录同一份模型 usage,汇总时就会把一次调用算成两次。可以将模型调用与工具调用拆成不同事件,以共同标识关联;模型用量只归属一次,工具各自记录执行时间和结果。
Trace 的 Prompt 应是发出请求时的快照。如果保存的是 messages 的同一个列表引用,后续追加结果会改变旧记录。最终纯文本答复和失败路径也需要事件,否则我们看得到工具过程,却不知道任务如何结束。配套 Engine 现在会记录 Provider、Tool、Policy 与 Run 终态,并用回归任务检查这些分支;下一步仍要在真实多进程 Runtime 中验证崩溃恢复与事件一致性。
大输出使用 Artifact 时,先保存内容,再把引用与哈希写入事件;读取时校验归属与权限。脱敏应发生在落盘前,原始内容不能因为是调试数据就无限保存。Trace 记录可观察输入、输出和控制事件,不承诺获取模型未公开的内部推理。
SubAgent 与跨服务 Trace 要传关联,不要复制整段上下文
Main Agent 委派任务时,把根 trace_id、父 Span ID、Run ID 和 delegation ID 传给 Child Run,Child 再创建自己的 Span。这样主任务、队列等待、子任务模型调用和工具执行可以串成一棵树。不要为了关联方便把完整 Prompt、凭据或 Memory 放进传播字段;跨服务携带的 baggage 应尽量小,并经过明确白名单。
如果消息会重试,消费端要保留消息 ID 与 attempt,避免把同一投递误看成两个业务任务。跨机器时间戳适合大致对齐,真正的父子关系仍以 ID 为准,因为不同主机的时钟可能存在偏差。
保存多少 Trace,需要分级
开发环境可以保留较完整的脱敏 Trace,生产环境则要按数据等级和用途选择:
错误与高风险 Run:优先完整保留
普通成功 Run:按比例采样或只留摘要
大体积 Observation:保存 Artifact 引用
敏感项目:缩短保留周期并限制查看角色
采样决定应尽量保持一个 Run 整体一致。如果只随机丢掉中间几条 Tool Event,留下来的“半条链”很难复盘。也可以采用尾部采样:Run 结束后发现失败、超时或触发高风险策略,再决定保留完整轨迹。
Trace 查询必须带租户、项目和 Run 所有权校验,并记录谁查看过敏感轨迹。删除用户数据时,也要覆盖 Trace、Artifact、备份与派生索引;“只是调试数据”不是无限保留的理由。
动手校账:一次模型、两个工具
安排一次返回两个工具调用的模型响应,再安排最终回答。参考验收是模型调用计数为二,两个工具各有记录,第一轮 usage 不重复,最终回答可查。随后继续修改 messages,确认已经保存的 Prompt 不发生变化。
















请登录后查看评论内容