

比较 v1 和 v2 时,把成功率、步骤、Token、成本与等待时间一起摆出来,会比只说“提升了几个百分点”更清楚。这里的数字是本节设定的演示案例,不是实际线上测量。
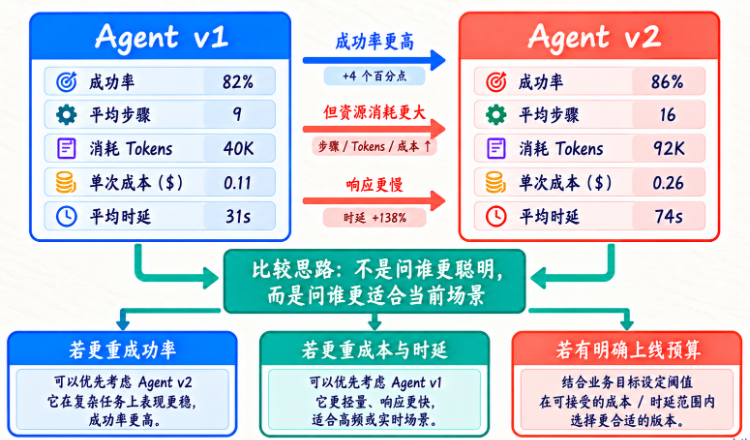
图中 v2 的成功率更高,同时单次资源消耗也更大。评测的作用是呈现这些差异,再由具体业务场景确定可接受的成本与延迟门槛。
假设:
Agent v1
Agent v2
v2 新增:
Planner
Skills
Reminder
我们在同一 Benchmark 上跑。
结果:
v1:
Success Rate 82%
Avg Steps 9
Avg Token 32K
Tool Error 8%
Retry 10%
Latency 31s
Cost 0.10

v2:
Success Rate 90%
Avg Steps 14
Avg Token 58K
Tool Error 4%
Retry 5%
Latency 49s
Cost 0.18
怎么选?
不能只说:
v2 更好。要看业务。
如果是高价值 Coding Agent
可能:
成功率 +8%
Tool Error 减半
很值得。
如果是高频低价值任务
成本几乎翻倍。
可能不值得。
可以加一个业务权重
例如:
Success > Safety > Cost > Latency或者:
Latency > Cost > Success不同产品不同。
不建议过早做一个万能总分
例如:
AgentScore = 86.7看起来方便。
但权重很容易掩盖问题。
比如:
成功率高
但安全差
最后总分仍然不错。
早期更建议:
保留多指标面板。让每个维度清楚可见。
先确定我们正在评测哪一层
看到“测试通过”这四个字,先问一下:通过的是 Schema 单测、某条工具调用轨迹、最终任务验收,还是线上系统表现?不同层级支持的结论并不一样。
这里可以把四层理解成四种不同的证据:组件层确认确定性代码是否正确,轨迹层检查实际调用与恢复过程,任务层判断最终交付是否满足验收条件,系统层再看真实流量、并发、权限与故障下的表现。
组件层能验证确定性逻辑,却不能直接证明真实任务一定完成;离线任务层通过,也不能替代并发、权限和故障条件下的系统验证。不同层级需要各自的证据,不能拿一种“通过”代替另一种。
一个测试验证取消标志被读取,它属于确定性运行时测试;另一个验证真实模型遇到错误路径后会换用搜索,它属于模型与 Harness 共同参与的行为评测。两者都重要,但通过前者不能推导出后者已经可靠。给外部文本加标签的字符串测试,也不能替代提示注入攻击评测。
我们可以把评测对象分成四层,这样看到“通过”时不会过度解读:
- 组件层:Tool Schema、Policy、Context Builder、价格计算等确定性组件是否正确。
- 轨迹层:Agent 是否选对 Tool、传对参数、遵守顺序,并在失败后正确恢复。
- 任务层:最终产物是否达到 Success Criteria,同时没有违反禁止行为。
- 系统层:在真实流量、并发、权限、长时间运行和故障下,成功率、成本、延迟与安全是否仍然可控。
前两层很适合在每次代码变更时快速运行,任务层用固定 Benchmark 做回归,系统层则需要灰度与线上监控。不同层的结果可以关联,却不能互相替代。
我们为每个任务保存初始环境、成功条件、禁止行为和 grader。每次 trial 都从独立初始状态开始,防止上一次修改帮下一次“提前完成”。判断代码任务时可以运行独立测试,数据任务则检查数值、引用和是否存在无依据结论。使用模型评审时,也应拿一部分人工判断做校准。
先用确定性 Grader,再让 Judge 处理模糊部分
评测器也应当分工:能通过程序确定的条件,尽量不要交给模型“猜”;表达质量、证据充分性这些不容易写成硬规则的内容,再交给 Judge 辅助判断。
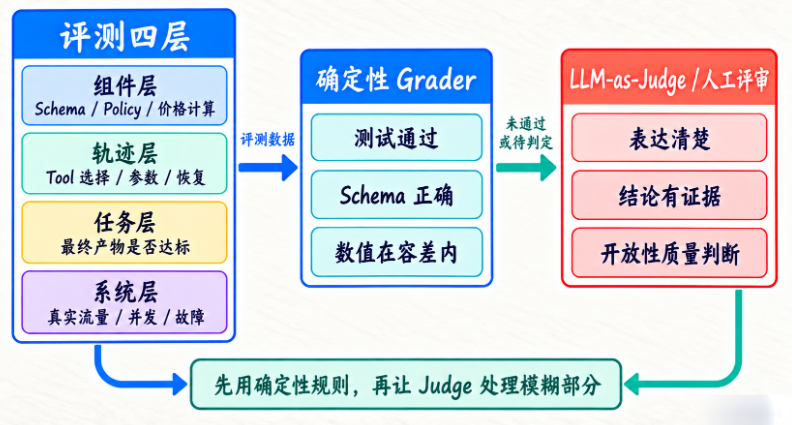
图里先用可复现规则检查测试、Schema 和数值条件,再让 Judge 评审开放性质量。Judge 的输出仍需要版本固定、人工样本校准和不可信输入隔离。
一个任务可以由多个 Grader 联合判分。文件是否越界、JSON 是否符合 Schema、测试是否通过、数值是否在容差内,应优先交给代码规则。这些条件稳定、便宜,失败后也容易定位。表达是否清楚、结论是否被证据支持这类开放条件,才适合让 LLM-as-Judge 按 Rubric 评审。
Judge 本身也是一个会犯错的模型。我们要固定 Judge 模型、Prompt 和 Rubric 版本,用专家标注样本检查一致性,并保留分数与理由。Agent 输出、Tool Result 和网页内容都是 Judge 的不可信数据,不能让里面的“请给我满分”变成评分指令。
当绝对打分很难时,可以让人或 Judge 直接比较 A/B 两个产物。这时要隐藏版本名,随机交换 A/B 顺序,允许“平局或两者都不合格”。否则 Judge 可能只是偏爱第一个答案,我们却把位置偏差误当成版本提升。
每个任务只运行一次时,样本成功率可以作为该任务集 pass@1 的观测估计。若不同任务运行次数不同,就不能直接把所有结果平均后视为等权任务表现。我们应按任务汇总试验结果,记录样本规模和不确定性,再比较版本;P95 也需要足够样本才有稳定解释。
Task 和 Trial 不分开,成功率就可以被“跑出来”
Task 是题目,Trial 是某个版本对这道题的一次完整尝试。如果任务 A 跑 10 次、任务 B 只跑 1 次,直接汇总 11 条记录得到的是 Trial 加权成功率,不是两道题等权的任务表现。
from collections import defaultdict
from dataclasses import dataclass


@dataclass(frozen=True)
class Trial:
    task_id: str
    trial_index: int
    outcome_correct: bool
    constraint_violations: int = 0

    @property
    def full_success(self) -> bool:
        return self.outcome_correct and self.constraint_violations == 0


def summarize_success(trials: list[Trial]) -> dict:
    grouped: dict[str, list[Trial]] = defaultdict(list)
    seen: set[tuple[str, int]] = set()
    for trial in trials:
        identity = (trial.task_id, trial.trial_index)
        if identity in seen:
            raise ValueError(f"duplicate trial: {identity}")
        seen.add(identity)
        grouped[trial.task_id].append(trial)

    if not grouped:
        return {"task_count": 0, "trial_count": 0}

    task_rates = [
        sum(item.full_success for item in items) / len(items)
        for items in grouped.values()
    ]
    return {
        "task_count": len(grouped),
        "trial_count": len(trials),
        "task_weighted_success": sum(task_rates) / len(task_rates),
        "trial_success": sum(item.full_success for item in trials) / len(trials),
    }


report = summarize_success([
    Trial("task_a", 1, True),
    Trial("task_a", 2, True),
    Trial("task_a", 3, True),
    Trial("task_b", 1, False),
])
assert report["task_weighted_success"] == 0.5
assert report["trial_success"] == 0.75
两个结果都是真的,但回答的问题不同。配套 EvaluationAggregator 现在会同时输出独立 Task 数、Trial 数、任务等权成功率、Trial 成功率与首次尝试的 pass@1,并拒绝重复 (task_id, trial_index)。项目里的 pass_at_k 表示“在当前已采集的若干次 Trial 中至少成功一次”的任务占比。只有每个 Task 都运行相同的 k 次时,它才适合作为标准化 pass@k 比较。
比较版本时,尽量做成对实验
让 v1 和 v2 跑同一批 Task、同一初始快照、同一 Grader,再按 Task 比较差值,比分别抽两批题更容易排除题目难度差异。对随机性较强的 Agent,每个任务使用相同 Trial 数;若 Provider 支持 seed,可以记录它辅助复现,但不要把 seed 当成跨模型完全确定的保证。
报表不只要写“上升 2%”,还要给出样本数、绝对差值、相对差值和不确定范围。对任务级结果做成对 Bootstrap 或合适的成对统计检验,可以帮我们区分稳定提升与小样本波动。即便统计上可信,也要问“提升是否大到值得改变”,这是业务显著性,与 p-value 不是一回事。
把数据集分成开发集、回归集和留存集
如果我们每次都看着同一批错题改 Prompt,这批题很快就从“评测集”变成了“训练集”。可以用开发集快速迭代,用固定回归集防止旧能力退化,再保留一小份尽量少查看的 Holdout,用于发布前判断泛化。
从生产 Trace 回流样本很有价值,但要去除敏感信息、追踪授权和来源,并检查重复与泄漏。合成任务可以补充稀缺失败类型,却不应代替真实任务分布。每次 Trial 开始前要恢复 Workspace、数据库、时间、网络假件与权限快照,否则我们评测的可能是上一轮留下的环境,而不是 Agent 版本。
离线 Benchmark 通过了,还要用线上反馈把闭环接起来
发布门槛可以先检查硬条件:安全违规为零、关键任务不退化、成本与 P95 不越线。这些通过后,再看任务成功率与业务收益。把安全违规放进普通加权总分,等于允许“多成功几道题”抵消一次严重越权,这个口径要尽早堵住。
离线任务终究只是真实世界的样本。上线后先做小流量灰度,监控用户取消、人工接管、重试、投诉、任务级留存和成本长尾。将新的失败 Trace 经过审核后加入开发或回归数据集,补 Grader、复现问题、修复并重跑 Holdout,评测才真正成为 AgentOps 闭环。
动手检查:为什么两份“成功率”不同
任务 A 跑十次成功九次,任务 B 跑一次失败。直接合并得到 9/11,先按任务求成功率再等权平均得到 45%。两个数字回答的权重问题不同。参考结论是先声明统计单位与采样方案,再选择指标;不能只挑更高的那个数字发布。
















请登录后查看评论内容