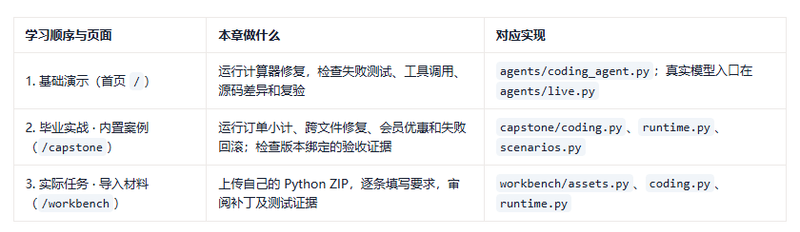


本章定位:从基础演示到 Coding 毕业实战
本章讲 Coding Agent。先用计算器观察“读、改、测”,再用订单业务检查完整交付,最后才把同一套思路用于自己的可信 Python 项目。三个页面服务于不同学习阶段;projects/12_final_agents/ 是启动入口目录,业务实现分别位于 src/agent_harness/agents/、capstone/ 和 workbench/。
第一次学习按表格顺序操作;已经理解基础循环的读者可以直接进入毕业实战。本章前半段详解订单案例,后半段保留计算器与简化代码,用于对照底层机制。首页的 Tracing & Metrics 用来观察运行,不是第三种 Agent;三个页面也不是三个独立服务。
启动后怎样完成第一次练习
所有命令都在 agent_harness_course_projects/ 目录执行,使用 Python 3.9。首次安装步骤见 项目 README。环境准备好后运行:
bash start.sh --check
bash start.sh
访问 http://127.0.0.1:5000/,先创建计算器示例并运行离线修复,再打开 /capstone 运行 Coding 的 single 案例。两者离线模式均使用已知教学策略;测试会真实执行,但离线成功不能证明模型能修复任意项目。真实模式需要在基础演示首页的“模型设置”中配置 Key,且会向模型服务发送任务材料与工具观察。
导入自己的代码前,先确认范围
/workbench 的 Coding 任务必须使用真实模型。ZIP 导入的是独立文本副本,须包含 Python 源码和 test_*.py 测试;最大 8 MiB、250 个文件、单文件 200 KB。工具只修改 Python 业务源码与新增开发测试,原有测试、规则和依赖配置受保护,不自动联网安装项目依赖。缺依赖时应得到 blocked_dependency,不能当作已修复。
本地 pytest 会执行项目代码,因此仅导入可信项目。每次运行的虚拟环境隔离依赖,不隔离当前用户的文件与网络权限。默认无需 Docker,当前工作台面向本机单用户教学。独立环境、结构化测试证据、依赖准备、检查点恢复、逐项验收和报告导出见 实际任务工作台手册。
完整课程验收无需模型;真实 Coding 发布验收是另外一步,须先启动服务并配置模型,会产生 API 用量:
python3 scripts/verify_course.py
# 可选:已配置真实模型后执行
python3 scripts/release_acceptance.py --url http://127.0.0.1:5000 --output .runtime/release-check
增强版实战:订单业务 Coding Agent 工作台
本次升级把“修复计算器的一行错误”扩展为四类可复现实战:单函数修复、跨文件修复、功能开发、失败回滚。原来的计算器案例与原理讲解保留在后面的“基础机制与最小演示”中。完成基础演示后,再按下文运行订单案例,并对照后面的最小代码理解哪些职责来自 Harness。
这一版的交付物是可核验的补丁、逐轮测试、版本记录和报告。 离线模式使用已知案例脚本,真实模型模式自主选择相同的工具;二者执行同一个 AgentEngine,接受同一个完成门禁。离线成功说明执行与验收链路可复现,不等于模型已经能修复任意项目。
1. 先运行,再认识工程结构
进入 agent_harness_course_projects,使用 Python 3.9:
python3 -m venv .venv
source .venv/bin/activate
python3 -m pip install -r requirements.txt -c constraints-py39.txt
python3 projects/12_final_agents/capstone_demo.py coding single
输出最后会显示报告路径。每次运行都会在 .runtime/capstone/ 创建新的目录,目录内有独立的 workspace/ 和 report.json。不要在已修改的案例上重复练习,否则基线状态与课程预期不同。
Web 入口:
bash start.sh打开本机 http://127.0.0.1:5000/capstone,或者点击基础演示首页里的“毕业实战 · 内置案例”。选择 Coding Agent,再选案例、运行方式,点击“开始运行”。页面提供执行过程、交付结论、逐轮测试、修改与回滚历史,以及补丁、JSON 和 Markdown 下载。
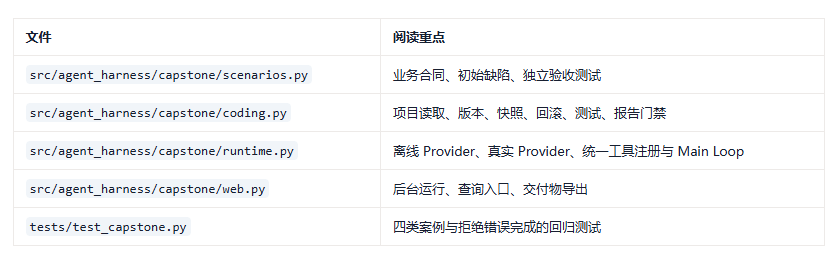
2. 用业务合同定义“修好了”
本案例是一个小型订单服务,拆为三个模块:
pricing.py      单价 × 数量 = 小计
    ↓
discounts.py    满 100 减 20;会员在满减后享九折
    ↓
orders.py       按顺序组合规则,返回结算金额
    ↓
tests/test_orders.py    独立验收
为什么不是只检查 checkout(50, 2, True) == 72?因为一个样例通过,可能只是碰巧。小计需要检查数量、零价格和小数;优惠需要检查 99、100、200 等边界;会员需要同时验证会员与非会员。集成测试还要验证“先满减,再折扣”的执行顺序。
这里的业务规则是课程明确给定的合同,不是让模型猜测的商业策略。进入真实项目时,应先把需求中的含糊处澄清,再确定测试与验收范围。
3. 四类任务与预期证据
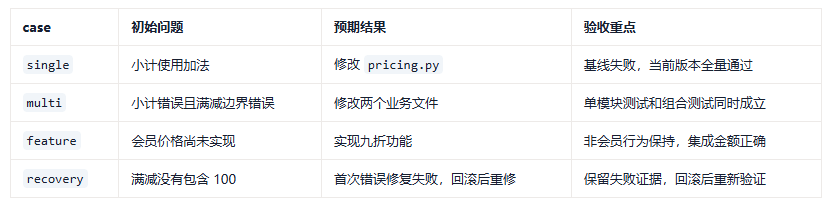
python3 projects/12_final_agents/capstone_demo.py coding multi
python3 projects/12_final_agents/capstone_demo.py coding feature
python3 projects/12_final_agents/capstone_demo.py coding recovery
会员案例采用验收驱动开发:独立验收测试保存在受保护的 tests/;Agent 可以通过 write_development_test 新增固定文件 development_tests/test_member_extra.py,验证小数金额与非会员行为。开发测试先在未实现功能上失败,再修复业务源码并执行完整测试。两类测试分开授权,不能通过改写验收测试降低交付标准。
4. 工具边界比工具数量重要
增强版向 Provider 暴露以下操作;开发测试工具仅在 feature 案例启用:
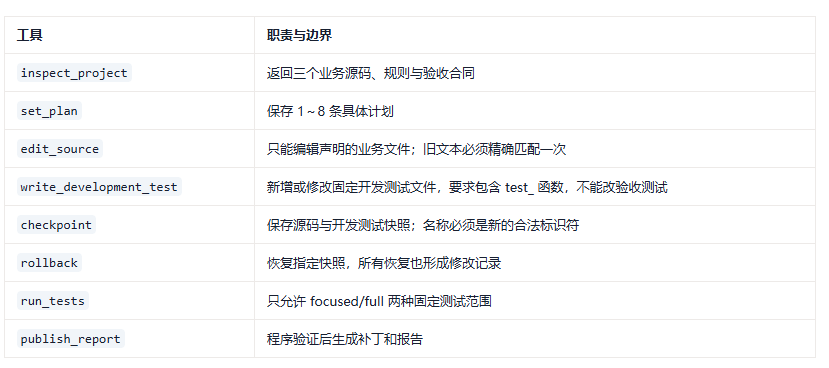
工具表按操作列出;checkpoint 与 rollback 是快照能力的两端。这里没有通用 Shell。Provider 无法通过任意命令参数绕过测试范围,也不能把 tests/test_orders.py 作为源码编辑目标。
这些约束面向本机可信教学项目。运行 pytest 仍然执行 Python 代码,工作目录约束不等于操作系统级隔离;不要把本案例的限制描述成可安全执行任意外来代码的生产沙箱。
5. 用 revision 绑定修改与测试
最容易出现的错误是:第二轮测试成功后,Agent 又编辑了文件,却沿用第二轮的成功结论。增强版给每次源码修改递增 revision,测试记录同时保存当时的版本。
def verified(latest_test, current_revision):
    return (
        latest_test.get("scope") == "full"
        and latest_test.get("returncode") == 0
        and latest_test.get("revision") == current_revision
    )
上面是说明门禁的独立小函数,实际入口在 CodingTools.publish_report()。真实实现还要求存在计划,且验收测试与规则文件指纹保持一致;feature 案例必须存在开发测试,full 同时执行 tests 与 development_tests。编辑或测试都会使已有报告失效,必须重新发布。
“曾经成功”不等于“当前成功”。 原有真实模型入口的完成检查也同步修正:后续出现失败测试时,不能继续使用前一次成功结果完成任务。
6. 为什么回滚也必须重新测试
运行 recovery 后,观察以下链路:
基线:100 元未满减 → 失败
首次尝试:把阈值改成 90 → 99 元也被减价 → 失败
回滚:恢复 before_fix 快照 → revision 继续递增
再次修复:阈值改成 >= 100
完整回归通过 → 生成报告
这个案例有意让第一次修复错误。离线 Provider 在看到失败观察后选择回滚;真实 Provider 不必采用同样路径,但必须达到同样的业务验收。
回滚恢复业务源码和开发测试的快照状态;如果快照中尚无开发测试,回滚会移除本轮新建的开发测试。回滚不能让历史测试自动变成有效证据。恢复操作也产生新的 revision,因此恢复后仍需测试。报告保留每轮 Diff,最终补丁只展示初始源码与最终源码之间的净变化,两者分别回答“发生过什么”和“最终交付什么”。
7. 离线与真实模型怎样共用执行链路
ScenarioProvider / DeepSeekProvider
                ↓
            AgentEngine
                ↓
       相同 ToolRegistry 与预算
                ↓
     CodingTools / publish_report
                ↓
      相同结构的报告与证据
ScenarioProvider 是已知案例的脚本决策器:它知道练习的预期修复,但每个动作仍经过工具参数验证、实际文件操作和真实 pytest。它不能替代模型能力评测。
真实模型入口:
export DEEPSEEK_API_KEY='替换为自己的 Key'
python3 projects/12_final_agents/capstone_demo.py coding multi --live
也可在基础演示首页配置 Key,然后在毕业实战 · 内置案例选择真实模型。真实运行会向外部模型发送教学源码、规则、任务与工具观察。课程无需真实 Key 即可完成所有离线验收;真实 API 效果应另行实测,不能由离线通过率推断。
8. 计划、状态与完成条件不是同一个东西
set_plan 保存的是可读计划,当前实现不会假装自动验证每条计划文字;计划项保留 planned 标记。真正是否交付由测试版本、保护文件和报告门禁决定。修改计划可以帮助解释策略变化,但不能把标记“完成”当成验证证据。
运行状态由共用 Run 服务保存;取消会在下一次 Provider 或 Tool 边界生效。已开始的 pytest 有超时上限,取消不承诺立即杀死当前测试进程。中途停止时保留已产生的修改与测试诊断,不伪装成完整交付。
9. 看懂报告,而不是只看绿色状态
下载 JSON 后依次检查:
mode是scripted还是live,避免混淆评测对象。report.tests[0]是否复现了初始错误。- 最后一条测试是否是 full、返回码 0、版本等于报告版本。
protected_unchanged是否为真。diffs是否只包含预期文件。edit_history是否能解释失败与回滚过程。unknowns是否准确说明验证范围。
Markdown 导出保留报告及结构化证据,Patch 导出可以用于人工审阅。下载补丁不会自动提交 Git、覆盖其他目录或发布代码。
10. 毕业作业与验收
基础作业: 跑完四个案例,提交每个案例的 JSON 和最终补丁。对 recovery 解释第一次失败的原因,以及为什么回滚后不能复用旧测试。
进阶作业: 为订单新增“运费门槛”规则,先定义独立验收,再增加业务文件、工具授权范围和场景脚本。不要只修改 Provider 中的预期答案。
评测作业: 加入“成功测试后又失败”“编辑后没有复测”“尝试修改验收文件”“预算不足”“用户取消”等反例;要求系统留下证据并拒绝错误交付。
python3 scripts/verify_course.py项目测试中包含四种业务案例、数据案例、HTTP 导出与门禁反例。新增功能时优先修改合同与测试,再修改运行实现;不要为通过测试而放宽完成条件。
11. 当前实现的边界
增强版是受控订单练习,不是任意仓库自动开发平台。它没有自动提交 PR、通用 Git 分支管理、任意文件创建、跨进程源码快照续跑或自动人工审批。开发测试仅开放固定文件,Python 语法与 test_ 函数检查并不构成安全沙箱。快照在单次运行内有效,运行目录与报告持久保存。独立 Skills、SubAgent 等能力仍可在前面的阶段项目学习,本项目不为凑组件而强制调用。
基础机制与最小演示(保留原有讲解)
下面的计算器、简化 Main Loop 和 Flask 片段用于逐步理解机制。增强版完整工程以本节前面的 capstone/ 模块与运行命令为准;后面的基础入口对应首页计算器演示,可用于入门对照。
走到这一节,我们开始把前面拆开的组件接回同一条执行链:让一个 Coding Agent 从接收任务,一直走到带证据的交付结果。
前面几十节,我们分别做了:
Agent Main Loop
Agent State
LLM Provider
Tool Calling
Tool Registry
Tool Schema
File / Shell / Python Tools
Error Recovery
Parallel Tool Calling
ContextBuilder
Working Memory
Session
Context Compaction
Long-term Memory
Flask API
Run Lifecycle
Streaming
SQLite
RunGuard
System Reminder
Middleware
Human in the Loop
Workspace / Sandbox
Planner
SubAgent
Skills
AGENTS.md
Tracing
Metrics
Evaluation
Failure Postmortem
如果单独看,每一个模块都只是一个组件。
真正的 Coding Agent,必须把它们串起来。
这一章我们的目标非常明确,给 Agent 一个陌生 Python 项目,让它自动定位并修复 Bug。
完整流程:
用户提交任务
 ↓
扫描项目
 ↓
读取 AGENTS.md
 ↓
查找相关文件
 ↓
读取代码
 ↓
运行测试
 ↓
分析报错
 ↓
修改代码
 ↓
再次测试
 ↓
测试通过
 ↓
输出修改报告
最终系统使用:
Python
+
Flask
+
LLM
+
Tool Registry
+
Memory
+
Tracing
并真正具备:
可运行
可约束
可追踪
可恢复
可验证
几个基本工程属性。
开场引入
先设想一个真实使用场景。
你拿到一个完全陌生的 Python 项目。
目录可能是:
project/
├── AGENTS.md
├── app/
│   ├── __init__.py
│   ├── service.py
│   └── config.py
├── tests/
│   ├── test_service.py
│   └── test_config.py
├── pyproject.toml
└── README.md
用户只告诉 Agent,“这个项目有一个 Bug,pytest -q 有失败,请你自动定位并修复。不能修改 tests/,也不能新增依赖。”
一个真正的 Coding Agent 不应该上来就:
猜代码
猜文件
猜根因
而应该先建立对项目的最小认识。
例如:
Step 1:
list_files

Step 2:
read AGENTS.md

Step 3:
read pyproject.toml

Step 4:
run pytest -q
拿到失败以后:
Step 5:
分析 traceback

Step 6:
定位相关文件

Step 7:
read_file

Step 8:
edit_file

Step 9:
pytest tests/test_service.py -q

Step 10:
pytest -q
只有全量测试通过,而且没有违反项目规则,Run 才进入:
COMPLETED这里有一个非常重要的思想,Coding Agent 不是“让 LLM 写代码”。
它真正做的是:
LLM
负责判断下一步

Harness
负责执行下一步

Tool
负责接触真实项目

Middleware / Sandbox
负责边界

Trace
负责记录

RunGuard
负责止损

Tests
负责验证
如果只让模型直接输出一个 Patch,那更像:
Code Generation而不是:
Coding Agent。真正 Agent 的关键,是它可以基于真实项目 Observation 不断调整策略。
知识地图
先把整条链路放在脑子里,会更容易理解后面每一个模块为什么要存在。下面这张图把从用户任务进入,到 Main Loop、Tool、Observation、Trace、Memory,再到最终报告的关系串了起来。你可以先整体看一遍,后面再回头对照,会更容易把这一章吃透。
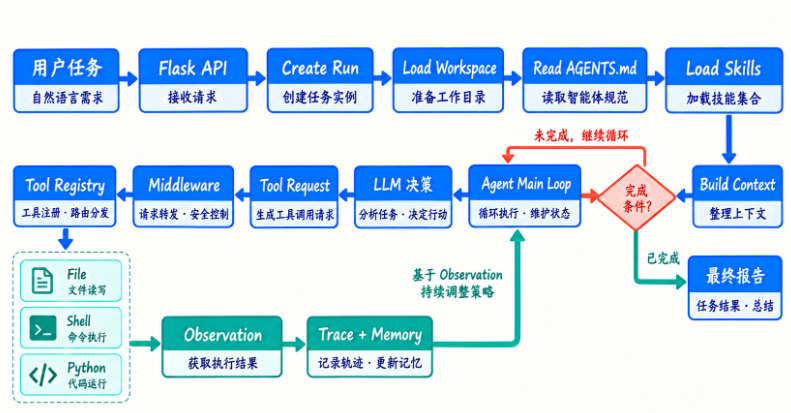
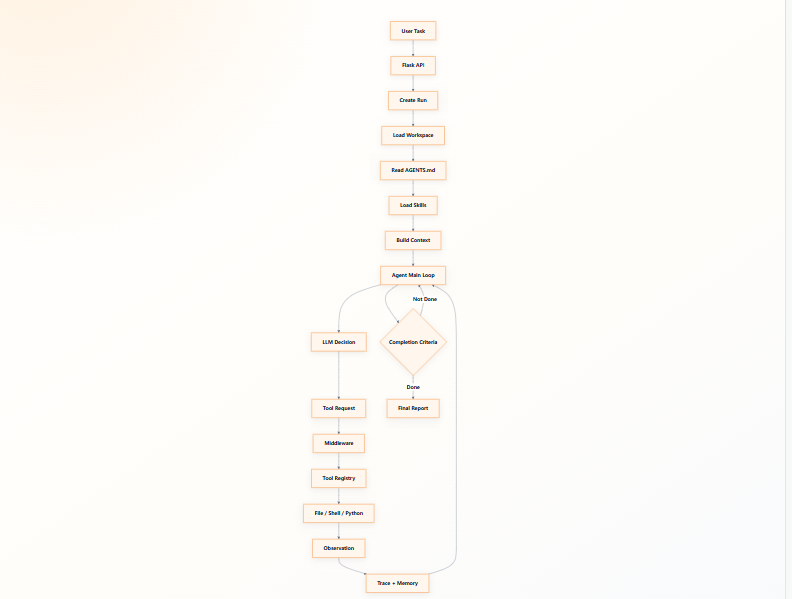
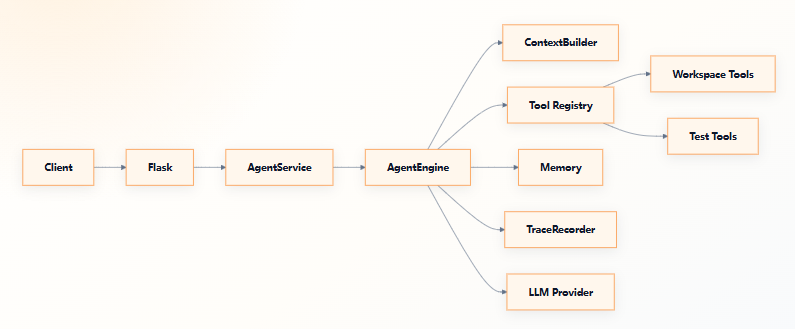
从工程架构看:
















请登录后查看评论内容