

当 Agent 从本地脚本走向服务化,重点就不只是“能跑”,而是请求怎么进来、Run 怎么创建、后台怎么执行、状态怎么流转、结果怎么返回。下面这张图把 Flask 接口、Run 生命周期和结果存储串成了一条很清晰的链路,也能帮助大家避免把所有逻辑都塞进 Flask Route 里。
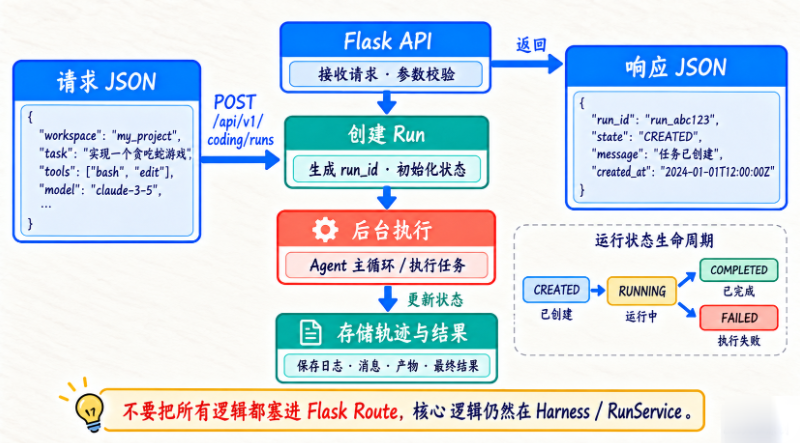
现在把 Coding Agent 接入 Flask。
核心接口:
POST /api/v1/coding/runs请求:
{
  "workspace": "workspace",
  "task": "修复当前 pytest 失败"
}
返回:
{
  "run_id": "run_xxx",
  "status": "running"
}
然后:
GET /api/v1/coding/runs/{run_id}查询状态。
为什么不建议一个 HTTP 请求一直同步跑到底?
复杂 Coding Agent 可能:
30 秒
2 分钟
10 分钟
所以更合理是:
Create Run
→ Background Execute
→ Query / Stream Status
课程第一版可以同步演示。
最小 Flask API:先把 HTTP 合同跑通
这段代码只验证请求、响应和 run_id 合同,并没有执行 Agent。它适合用来确认前端如何创建和查询 Run,但不能因为返回了 ready,就认为任务已经在后台运行。下一步还要把:
AgentService接进 create_run(),由后台执行器推进状态,并把 Trace、测试结果和错误写入持久化存储。仓库中的完整 Web 示例已经走这条路径;上面的内存字典只是帮助我们看清接口边界。
成熟架构
Flask
 ↓
AgentService
 ↓
AgentEngine
 ↓
ContextBuilder
 ↓
LLM Provider
 ↓
Tool Registry
 ↓
Middleware / Sandbox
 ↓
Trace / Memory
而不是把所有逻辑都塞 Flask Route。
交付代码之前,我们再检查一次证据
这一部分我建议大家一定要多看两遍。因为到了真实项目里,模型说“完成了”并不等于真的可以交付。真正更稳的做法,是先做预检:检查未提交修改、确认 workspace 边界、执行相关测试、确认是否触及受保护文件,最后再经过 Completion Gate 做统一判断。下面这张图把“证据优先”的交付思路整理成了一个可复用的流程。
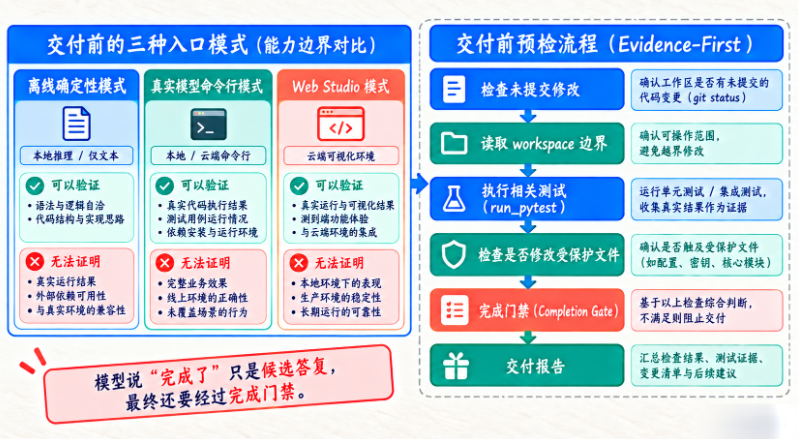
我们把终点定义得具体一些:指定任务得到处理,允许范围内的修改可查看,测试结果可复核,未完成事项明确说明。模型输出“完成了”只是一个候选答复,最终状态还应经过完成门禁。测试通过也可能覆盖不足,因此要保留需求对应检查和独立回归测试。
离线示例根据固定错误模式修改运算符,适合观察工具链。真实模型模式复用同一套 Registry 和 Middleware,并接入 RunGuard、可选 TraceRecorder 与测试完成门禁:如果最后一次修改之后没有成功的 run_pytest,模型即使输出“完成”,Run 也不会进入 COMPLETED。这里描述的是基础真实模型执行器;Web 会通过 RunService 包装它,增加后台运行与持久化。命令行运行本身不能证明 Web 生命周期、审批恢复或多用户隔离已经完成,当前工作台仍面向本机单用户教学。
工作前检查是否存在用户未提交修改,补丁尽量以已读版本为前提。隔离工作区可以减少互相影响,但仍需说明产物如何合并回来。遇到无法安全修改或证据不足的情况,保留失败与部分成果,比生成一份笼统成功报告更有用。
基础演示的启动与决策方式
下面按离线脚本、真实模型命令行与 Web 体验区分验证范围。它们不同于本章开头的三个页面入口:基础演示和毕业实战都可以从命令行或 Web 启动,也都能选择离线或真实模型。
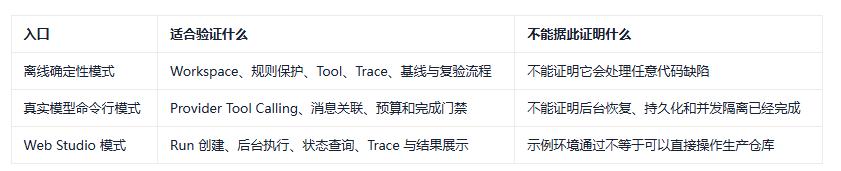
离线策略目前只识别课程示例中的几类运算符错误。遇到它没有把握的错误,会返回 failed 并说明能力边界。这不是“没做完”,而是避免用不可靠修改伪装成功。真实模型能扩大判断范围,但安全边界和完成证据不能一起放宽。
运行前先做一次 Preflight
开始修改之前,我们至少保存下面几类基线:
workspace 的规范化绝对路径
本次任务与 run_id
生效的 AGENTS.md 指纹
项目文件扫描结果
第一次 pytest 的退出码与输出
tests/ 和依赖清单的内容指纹
这里的指纹不是为了炫技。它解决的是一个很实际的问题:最终测试虽然绿了,但测试文件或依赖声明也被顺手改了,我们还能不能把它算作成功?课程项目会在修改前后比较受保护文件;只要这些文件发生变化,即使 pytest 返回 0,也不会通过交付门禁。
当 AGENTS.md 写明“不允许新增第三方依赖”时,这条规则还会继续下沉到 Workspace Tool 和 Middleware,依赖清单写入会被直接拒绝。前置拒绝负责阻止动作,前后指纹负责核验结果,两层证据各有作用。这里采用的是偏保守语义:Tool 无法可靠判断一次文本替换究竟是“新增依赖”还是“整理依赖”,因此规则生效时会保护整份依赖文件;确实需要调整时,应先修改项目规则并走单独授权。
如果面对的是真实 Git 仓库,还应记录起始提交和已有未提交修改。已有改动默认属于用户,Agent 不能把它们当成自己产生的 Diff,更不能为了“恢复干净”擅自覆盖。更稳妥的做法是使用隔离工作区,或者在报告里把基线改动与本次改动分开列出。
edit_file 也要防止“改对一处,误伤另一处”
只检查 old in content 还不够。如果相同片段出现三次,replace(..., 1) 会静默修改第一处,而第一处未必是 Agent 刚读到的那一处。因此课程项目把编辑合同收紧为:
old 不能为空
old 和 new 不能相同
old 在当前文件中必须恰好出现一次
tests/、AGENTS.md 和敏感路径继续受保护
一旦匹配数不是 1,Tool 直接失败,Agent 需要重新读取文件并提供更完整的上下文。这个失败很有价值,它提示我们文件可能已经变化,或者 Patch 本身含糊。不要在这里偷偷降级成宽泛替换。
更完整的生产实现还会携带读取时的文件摘要,在写入前做一次 compare-and-swap。这样同一文件被用户或另一个 Run 更新后,当前 Run 会得到冲突,而不是覆盖较新的内容。
测试门禁要看顺序,不只看“曾经通过”
下面两条 Trace 的结果完全不同:
run_pytest(returncode=0) → edit_file → 模型说完成第一条不能交付,因为通过的是修改前版本。真正满足门禁的顺序是:
edit_file → run_pytest(returncode=0) → 完成检查实现时,我们记录最后一个 edit_file 和最后一个成功 run_pytest 在 Tool History 中的位置。只有成功测试发生在最后一次编辑之后,verified_after_last_edit 才为真。若没有发生修改,基线测试通过也可以完成,因为它证明当前项目原本就满足测试条件。
测试本身也建议分层推进:先运行和故障直接相关的测试,快速得到反馈;再运行项目规定的完整测试命令,防止局部修复引入回归。pytest 没安装、收集阶段报错、超时和断言失败是四类不同 Observation,不要把“测试没跑起来”误写成“没有失败测试”。
最终报告至少回答六件事
一份可复核的 Coding Report 不需要写得很长,但需要把关键证据放齐:
接到的任务是什么
基线为什么失败
根因定位到哪里
实际修改了哪些文件
修改后的测试结果是什么
规则、测试和依赖清单是否保持合规
课程项目现在同时保留 baseline_tests、最终 tests 和 evidence。如果复验失败,源码修改可以保留供你检查,但状态必须是 failed,报告也要明确还有什么没有闭环。是否自动回滚不是一个可以偷偷决定的细节:回滚便于保持工作区整洁,保留现场便于调试;真实产品应把这个策略做成显式配置,并避免覆盖用户并发产生的修改。
按 Python 3.9 跑通完整示例
在项目根目录执行:
python3 -m venv .venv
source .venv/bin/activate
python3 -m pip install -r requirements.txt -c constraints-py39.txt
bash start.sh --check
bash start.sh --coding
启动 Web Studio 使用:
bash start.sh启动后也可以在左侧“模型设置”中填写 DeepSeek API Key,再回到 Coding Agent 页面选择“DeepSeek 真实模型”。Key 只保存在本机服务进程内存中,重启即清除,不会写入源码、.env、SQLite、Trace 或浏览器存储。选择真实模式意味着项目规则、任务上下文和必要的 Tool Observation 会发送到 DeepSeek API,并可能产生费用。
真实模型模式需要额外设置 DeepSeek 凭证和工作区路径:
export DEEPSEEK_API_KEY='替换为自己的 Key'
export DEEPSEEK_MODEL='deepseek-flash'  # 可省略,课程默认值
export CODING_WORKSPACE='./复制出来的示例目录'
python3 projects/12_final_agents/live_coding_demo.py
第一次练习建议使用复制出来的示例目录;等 Workspace、规则保护和测试门禁都验证过,再接入自己的仓库。真实代码会作为模型上下文发送给 API,不要拿包含密钥、客户数据或未公开源码的目录做第一次实验。
动手验收:换一个固定策略不会修的错误
在复制的项目中加入边界条件错误,而不是另一个运算符替换。参考验收包含基线失败、定位依据、最小 diff、相关与回归测试结果,以及未修改受保护文件的证据。若离线策略明确报告能力不足,这是正确边界;若真实模式没有执行测试便宣布完成,则门禁还需完善。
















请登录后查看评论内容