

先把一个很重要的边界说清楚,Python 内存中的对象,不等于系统真正“记住”了。
例如:
sessions = {}
runs = {}
它们非常快。
但生命周期只等于:
当前 Python 进程生命周期服务一重启:
全部重新初始化内存适合什么?
内存很适合:
当前正在运行的对象
临时缓存
事件队列
最近热数据
比如:
当前 Run 的 Event Queue就很适合放内存。
因为 SSE 正在实时消费。
但像:
Session
Run
Message
Step
Tool Call
这些属于业务历史。
如果只在内存里,就会有几个非常明显的问题。
问题一:服务重启后历史消失
这是最直观的。
用户昨天的 Session 今天找不到。
Run 页面刷新后 404。
这在产品里基本不可接受。
问题二:无法真正做审计与复盘
后面我们要做 Tracing。
你会希望回答:
这个 Run 为什么失败?
第 7 步模型做了什么?
哪个 Tool 参数传错了?
失败之前读过哪些文件?
如果所有内容只在内存中,任务结束以后很快就丢。
问题三:多个 Worker 无法共享 Python dict
生产 Flask 往往不会只跑:
一个 Python 进程可能:
Gunicorn Worker 1
Gunicorn Worker 2
Gunicorn Worker 3
如果 Session 在:
worker_1.sessions请求下一次被负载均衡到:
worker_2它根本看不到。
所以,多进程以后,进程内 dict 不能再作为唯一事实来源。
问题四:无法稳定做查询
比如产品想支持:
最近 20 个 Runs
失败的 Runs
某个 Session 下全部任务
某个 Run 全部 Tool Calls
数据库 SQL 天生擅长。
Python dict 做这些越来越麻烦。
问题五:无法做后续统计
后面 AgentOps 会统计:
Run Success Rate
平均 Steps
Tool Error Rate
Latency
Token
Cost
这些都要求历史数据存在。
所以持久化不仅为“恢复”。
也为,观测和分析。
把内存状态和持久化状态并排看,会更容易理解为什么 Agent Backend 最终一定要引入数据库。Python dict 很适合保存当前进程里的热状态,但只要服务重启、多 Worker 运行,或者我们要做历史查询与审计,它就不再适合作为唯一事实来源。
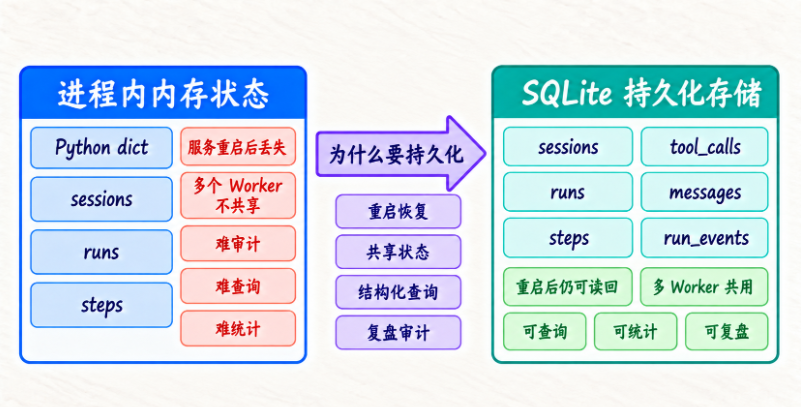
这张图想强调的不是“SQLite 一定比内存好”,而是两者职责不同:内存负责快,数据库负责不丢、可查、可复盘。 当前事件队列仍然可以留在内存里,但 Session、Run、Step、Tool Call 这类业务历史需要落到进程之外。
SQLite 为什么适合作为第一版?
它非常适合当前阶段。
不用启动:
mysqld
postgres
只需要:
agent.dbPython 标准库:
import sqlite3就能用。
SQLite 的局限也要知道
SQLite 不是所有生产 Agent 的最终答案。
如果以后:
很多实例同时写
复杂事务
大量并发
跨机器访问
更适合:
MySQL
PostgreSQL但我们当前最重要的是,先把数据模型和接口设计正确。
因为数据库以后可以换。
业务模型不能乱。
















请登录后查看评论内容