

很多人第一次持久化 Agent,会想:
建一张 agent_runs
然后所有东西 JSON 全塞进去
比如:
{
  "session": {...},
  "messages": [...],
  "steps": [...],
  "tool_calls": [...]
}
Demo 很快。
但后面查询会很痛苦。
我们这次用关系表把核心实体拆开。
sessions
Session 是会话容器。
至少保存:
session_id
status
created_at
updated_at
可以继续有:
metadata
working_memory
historical_summary
本章先保留基础字段。
runs
Run 属于 Session。
核心:
run_id
session_id
status
start_time
end_time
error
answer
这里 session_id 是外键关系。
steps
Run 中多个 Step。
保存:
run_id
step_no
kind
detail
created_at
以后 Trace 会继续增加:
latency
tokens
status
tool_calls
Tool Call 是非常重要的一类独立记录。
为什么不全塞 steps?
因为 Tool Call 有非常结构化的字段:
tool_name
arguments
result
status
error
started_at
ended_at
以后做:
Tool Error Rate
某个 Tool 调用次数
平均耗时
非常方便。
messages
Message 属于 Session。
保存:
role
content
created_at
角色可能:
user
assistant
system
tool
不过 Tool Result 是否同时保存 messages 和 tool_calls,要根据架构决定。
本课程建议:
tool_calls
保存工具执行记录

messages
保存进入 Conversation History 的消息
职责分开。
run_events
上一节的 SSE 还需要一份可恢复的事件日志。它不是完整 Trace,也不是 Message,而是面向订阅者的产品级事件:
id
run_id
event
data
created_at
id 充当 Last-Event-ID 游标,客户端断线后按它补发。这里不要复用内存 Queue:Queue 适合即时通知,run_events 才负责历史事实。配套项目正是“SQLite 回放 + 条件变量唤醒”这套组合。
一条完整运行链路怎么落表?
例如:
User:
修复项目
先写:
messages创建 Run:
runsAgent 第1步:
steps调用:
read_file写:
tool_callsTool Observation 再成为上下文消息时:
messages最终 Run 完成:
update runs这就是一个很自然的持久化链。
把这些实体真正连起来以后,表之间的关系就会比单独背字段直观很多。sessions 是会话容器,一个 Session 可以包含多个 Run;Run 再向下关联 Step、Tool Call、Message,同时用 run_events 保存面向订阅者的事件历史。
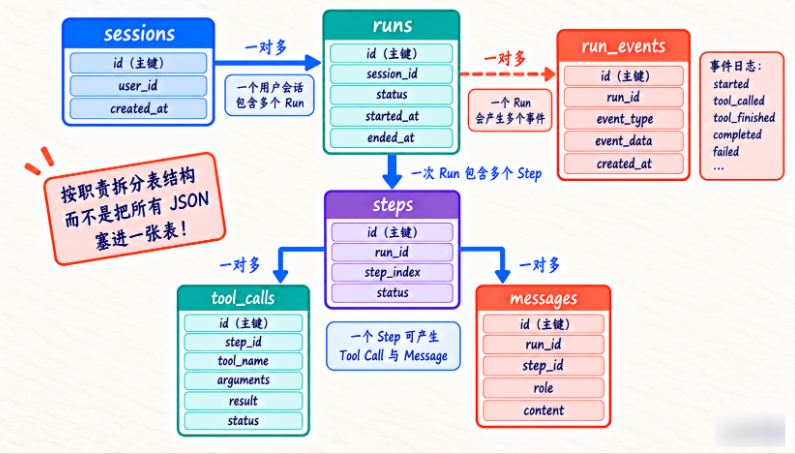
这里最重要的设计原则是按职责拆表,而不是把所有 JSON 塞进一个大字段。这样后面查询失败 Run、统计某个 Tool 的错误率、回放某次执行路径,都可以直接围绕结构化关系完成。
从一次真实请求的时间顺序再看一遍,落表动作会更容易对应到 Agent 的运行过程:创建 Session、创建 Run、写 Step、记录 Tool Call、保存 Observation / Message,最后再把 Run 更新到完成或失败。
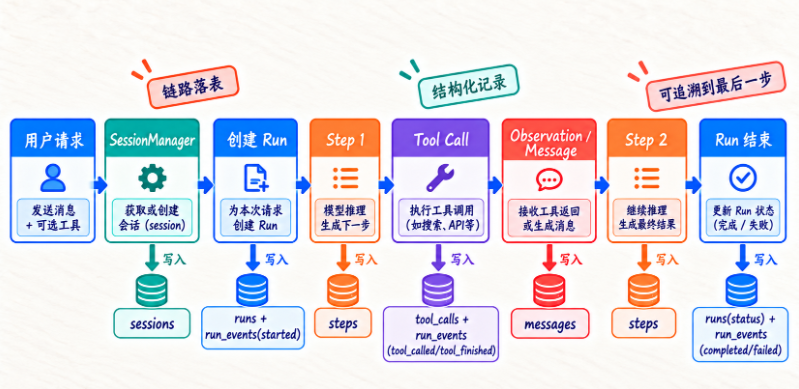
这样的结构有一个直接好处:以后排障时可以从 run_id 一路追到 Step、Tool Call 和事件,不需要从几十 MB 文本日志里重新拼整条执行链。
表设计 SQL
下面先给一版基础 Schema。
CREATE TABLE IF NOT EXISTS sessions (
    session_id TEXT PRIMARY KEY,
    status TEXT NOT NULL,
    created_at TEXT NOT NULL,
    updated_at TEXT NOT NULL
);

CREATE TABLE IF NOT EXISTS runs (
    run_id TEXT PRIMARY KEY,
    session_id TEXT NOT NULL,
    status TEXT NOT NULL,
    start_time TEXT,
    end_time TEXT,
    answer TEXT,
    error TEXT,
    FOREIGN KEY (session_id)
        REFERENCES sessions(session_id)
);

CREATE TABLE IF NOT EXISTS steps (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    run_id TEXT NOT NULL,
    step_no INTEGER NOT NULL,
    kind TEXT NOT NULL,
    detail TEXT NOT NULL,
    created_at TEXT NOT NULL,
    FOREIGN KEY (run_id)
        REFERENCES runs(run_id)
);

CREATE TABLE IF NOT EXISTS tool_calls (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    run_id TEXT NOT NULL,
    tool_name TEXT NOT NULL,
    arguments TEXT,
    result TEXT,
    status TEXT NOT NULL,
    error TEXT,
    created_at TEXT NOT NULL,
    FOREIGN KEY (run_id)
        REFERENCES runs(run_id)
);

CREATE TABLE IF NOT EXISTS messages (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    session_id TEXT NOT NULL,
    role TEXT NOT NULL,
    content TEXT NOT NULL,
    created_at TEXT NOT NULL,
    FOREIGN KEY (session_id)
        REFERENCES sessions(session_id)
);

CREATE TABLE IF NOT EXISTS run_events (
    id INTEGER PRIMARY KEY AUTOINCREMENT,
    run_id TEXT NOT NULL,
    event TEXT NOT NULL,
    data TEXT NOT NULL,
    created_at TEXT NOT NULL,
    FOREIGN KEY (run_id)
        REFERENCES runs(run_id)
);

CREATE UNIQUE INDEX IF NOT EXISTS idx_steps_run_step
    ON steps(run_id, step_no);

CREATE INDEX IF NOT EXISTS idx_tool_calls_run
    ON tool_calls(run_id, id);

CREATE INDEX IF NOT EXISTS idx_messages_session
    ON messages(session_id, id);

CREATE INDEX IF NOT EXISTS idx_run_events_cursor
    ON run_events(run_id, id);
索引不是“表建完以后有空再说”的装饰。它应该贴着真实查询路径设计:按 Session 读取消息、按 Run 读取 Step 和 Tool Call、按事件 ID 做断线续传。反过来,也不要因为“可能有用”就给每个字段建索引;写入时每个索引都要同步维护,会增加成本。
为什么时间先用 TEXT?
SQLite 没有像某些数据库那样严格的 DATETIME 类型。
使用 ISO 8601:
2026-09-06T12:30:00+00:00作为 TEXT,很容易:
读
写
排序
迁移
教学阶段足够。
为什么 arguments / result 用 TEXT?
因为 Tool Arguments 通常是 JSON。
SQLite 中可以:
json.dumps(...)后写入 TEXT。
读取再:
json.loads(...)这是第一版很实用的做法。
















请登录后查看评论内容