

现在真正写代码。
我们不希望:
RunManager里面到处:
sqlite3.execute(...)因为以后换 PostgreSQL 会很痛苦。
所以先抽象:
Storage第一版接口
可以先定义:
create_session
get_session
append_message
create_run
update_run
append_step
append_tool_call
get_run
list_steps
底层 SQLiteStore 实现它。
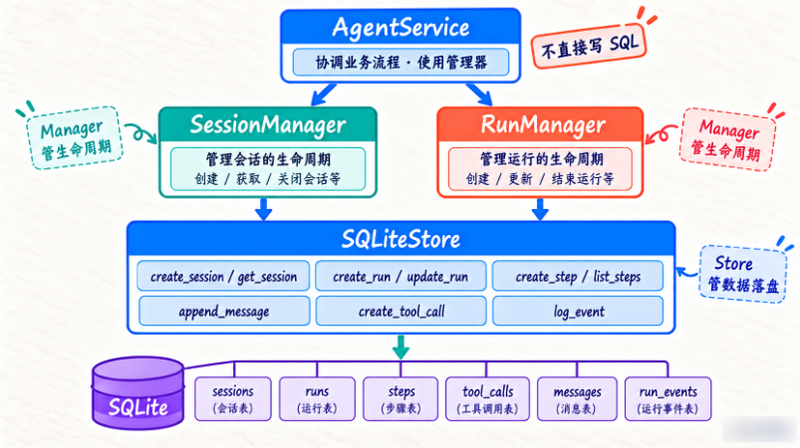
这里最好把 SQLiteStore 看成“数据落盘边界”,而不是一个随手封装的数据库工具类。上层 Manager 只描述业务生命周期,具体 SQL、事务、连接管理和表结构全部收进 Store。
这样 Route、AgentService、SessionManager 和 RunManager 都不需要知道 sqlite3.execute() 应该怎么写。数据库实现细节集中以后,迁移、测试和事务控制都会简单很多。
完整可运行 SQLiteStore
下面代码会创建:
./data/agent.db并初始化五张核心业务表。为了先控制代码长度,示例把 run_events 的实现留到后面的“状态与事件同事务”小节;配套项目已经包含这张表。
这段代码跑完后,会真正生成:
data/agent.db你停掉程序,再运行读取逻辑,数据还在。
这就是持久化。
为什么要单独封装 _connection()?
sqlite3.Connection 自带的 with conn: 只负责事务提交与回滚,并不保证连接关闭。这一点很容易被代码外观误导。所以示例再包一层上下文管理器,把完整生命周期收在同一个地方:
连接打开
执行事务
正常退出自动提交
异常自动回滚
finally 中明确关闭连接
这样 Route、Manager 和 Store 方法都不需要记住 close(),也不会把连接释放交给不确定的垃圾回收时机。
小规模 SQLite 服务很适合这种写法。
为什么开启 Foreign Keys?
SQLite 默认外键约束并不总是自动启用。
所以我们显式:
PRAGMA foreign_keys = ON这样:
不存在的 session_id就不能随意创建关联 Run。
这能减少脏数据。
注意 PRAGMA foreign_keys = ON 是连接级设置。只在建库时执行一次不够,每个新连接都要开启。busy_timeout 也放在连接初始化里,让短暂写锁冲突先等待几秒,而不是立刻抛出 database is locked。
WAL 能改善并发,但不会把 SQLite 变成分布式数据库
示例初始化时启用了:
PRAGMA journal_mode = WAL;WAL 允许读操作与一个写操作更好地并行,适合本机 Web 服务常见的“持续写 Step,同时读取 Run Detail”场景。不过 SQLite 仍然只有一个写入者能在同一时刻提交。事务要短,网络请求、模型调用和 Tool 执行都不要包在数据库事务里;否则一个慢 Tool 就可能把其他写入全部堵住。
数据库升级时,别把“删库再建”当成方案
CREATE TABLE IF NOT EXISTS 适合第一次教学建库,却不能处理“表已经存在,现在要增加字段或索引”。配套 SQLiteStore 使用 PRAGMA user_version 记录 Schema 版本,并把变更按编号放进 MIGRATIONS:
MIGRATIONS = (
    (1, "CREATE TABLE ..."),
    (2, "CREATE INDEX ..."),
    (3, "CREATE TABLE sessions ..."),
)
新数据库顺序执行全部迁移;旧数据库只执行尚未应用的版本;已经升级完成后再次启动,不重复修改结构。迁移还要用旧版本数据库做回归,确认历史 Run 没有被覆盖。IF NOT EXISTS 可以帮助早期课程数据库平滑接入版本标记,但它不能代替真正的迁移步骤。
迁移版本解决的是“结构怎么演进”,不是“正在执行的任务怎么恢复”。服务崩溃后遗留的 running Run、外部工具是否已产生副作用、以及从哪个检查点继续,仍需要独立恢复协议。
Run 状态与对应事件要在同一事务
如果我们先执行:
UPDATE runs SET status = 'completed'提交后进程恰好崩溃,还没写入 run.completed,状态查询和 SSE 历史就会互相矛盾。反过来先发事件也一样危险:客户端已经看到完成,但结果尚未保存。
配套项目通过 update_run_with_event() 把状态、结果和事件放在同一个事务里:
with store.connection() as conn:
    conn.execute(
        "UPDATE runs SET status=?, result_json=?, updated_at=? "
        "WHERE run_id=?",
        ("completed", result_json, now, run_id),
    )
    conn.execute(
        "INSERT INTO run_events "
        "(run_id, event, data_json, created_at) "
        "VALUES (?, ?, ?, ?)",
        (run_id, "completed", event_json, now),
    )
两条语句一起成功,或者一起回滚。事务提交之后,再通知 SSE 订阅者读取 SQLite。这里的顺序很关键:通知只是“有新数据了”的提示,数据库才是事实来源。
















请登录后查看评论内容