

读到这里,几种信息来源就可以放到一张图里看了。AGENTS.md 给出项目约定,Skill 提供做某类任务的方法,Memory 保留相关历史信息,而 Middleware 在真正调用工具时承担程序化检查。
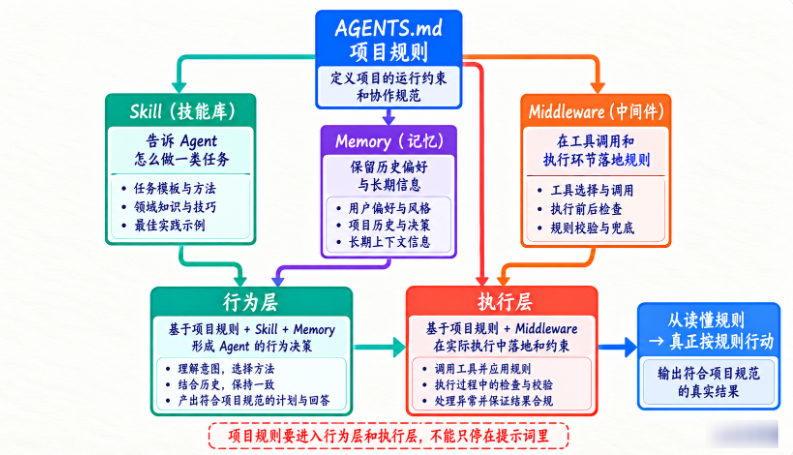
看图时重点抓住两条线:一条是“让模型理解该怎么做”,另一条是“让系统检查实际上能不能做”。项目规则如果只停在提示词里,就还没有覆盖完整的执行边界。
这一节最重要的不是文件读取。
而是,规则到底怎么真正影响 Agent。
可以分两层。
第一层:Context 行为层
把:
AGENTS.md注入 ContextBuilder。
模型因此知道:
不能修改 tests/
必须 pytest
不能新增依赖
这有助于:
减少错误 Tool Request第二层:执行保障层
对于关键规则,再转成 Middleware Policy。
例如:
不允许修改 tests/解析后:
allow_modify_tests = False当模型仍然请求:
edit_file("tests/test_x.py")Middleware:
DENY这就形成:
软规则
+
硬执行
双层保证。
Skill 在这里扮演什么角色?
假设加载:
python-debugSkill 说:
优先最小修改
修复后跑测试
而 AGENTS.md 说:
测试命令必须 pytest -q
禁止修改 tests/
两者结合:
Skill
→ 通用方法

AGENTS.md
→ 当前项目特殊约束
Memory 在这里扮演什么角色?
Memory 可能记录:
上次用户明确拒绝升级依赖如果这个决策后来变成项目长期规则,最好:
更新 AGENTS.md而不是只靠 Memory。
为什么?
因为 AGENTS.md 是:
项目显式规则更容易审阅、版本控制、团队共享。
Memory 更适合:
补充历史上下文。Human in the Loop 怎么配合?
如果规则是:
不允许修改 tests/通常:
DENY如果规则是:
默认不允许新增依赖,
确有必要时需人工批准
那可以:
REQUIRE_APPROVAL这就和上一章无缝接上。
Rule Trace
建议记录:
加载了哪些 AGENTS.md
哪些规则被触发
哪个 Tool Request 因规则被拒绝
规则版本是什么
以后你能回答:
为什么这个 Agent 没改 tests/?
为什么这个 Tool 被 block?
这就是生产级可审计能力。
为 Run 固定规则快照
只记录“读过 AGENTS.md”还不够。一次 Run 至少应保存:
适用目标路径
按顺序加载的规则文件
每个文件的内容摘要
组合后的规则 fingerprint
解析出的结构化 Policy
发现的冲突与处理结果
这样我们才能复现“当时为什么允许或拒绝了这个动作”。如果执行期间规则文件发生变化,不要让正在运行的 Agent 无感切换:普通推理继续使用已记录快照;准备产生副作用前可以重新校验 fingerprint,发现变化就暂停并重新构建 Context。这个检查能减少“模型看到旧规则,执行层已经换成新规则”的时间差问题。
不要让 Agent 先改规则,再绕过规则
一个很隐蔽的路径是:Agent 发现 tests/ 不能改,于是先把 AGENTS.md 中的禁止条款删掉,再重新加载。技术上它完成了两次普通文件写入,治理上却等于自己给自己提权。
所以规则文件本身通常要进入保护范围。普通 edit_file 不直接修改 AGENTS.md;确实需要调整规则时,走单独的审批或维护入口,记录旧摘要、新摘要、操作者和理由,然后让后续 Run 使用新版本。保护规则文件不是说它永远不能改,而是不能由受它约束的执行路径悄悄改。
仓库里的规则也要考虑信任来源
团队自有仓库中的 AGENTS.md 通常是可信项目说明,但从外部下载或刚克隆的仓库仍可能带有诱导读取凭据、上传代码等恶意指令。规则文件的作用域只能约束当前项目,不能提升 Tool 权限,也不能覆盖 System 安全边界。涉及外部网络、凭据和系统目录的动作仍由 Middleware 与 Sandbox 判定。
读取规则之后,还要检查规则实际生效的位置
我们在项目根目录看到通用要求,在子目录看到更具体的测试命令。先确定当前要操作的文件,再按课程采用的作用域规则收集相关说明,并记录最终采用哪些版本。不同产品的发现顺序和优先级可能不同,课程应将自己的约定写清楚,避免把一个 Loader 的行为当作通用标准。
把规则读进内存不代表模型已经看见。我们应检查最终 Context,确认相关要求确实被注入。配套 Live Coding 入口现在会把带来源与摘要的规则正文放进真实模型请求,并用回归用例检查这一点;确定性 Coding Agent 的 Trace 也会保存当步使用的规则内容。
禁止修改 tests 等硬约束还要在执行层落实。路径规范化后检查真实目标,避免相对路径或符号链接绕过。至于代码风格和测试命令,可以通过提示与后续验证共同保障,发现冲突时明确说明采用依据。
这里也要注意实现边界:配套项目把“禁止修改 tests/”接入了 Middleware 和 Workspace Tool,并保护 AGENTS.md 本身;“不允许新增依赖”目前会被解析和展示,但还没有一个能可靠判断依赖新增、升级、删除差异的专用 Policy Parser。它不能只靠字符串命中就宣称已经硬执行。多目标动作的逐次动态 Policy、规则持久化与跨进程快照也仍是后续生产化工作。
动手核对:规则是否只停留在文件里
给子目录添加一条可验证的格式要求,再构建一次实际模型请求。参考验收是请求包含适用规则、无关目录规则未混入、动作记录能说明规则来源。对硬约束另做工具越权测试,不能只检查 Prompt 中出现了文字。
















请登录后查看评论内容