



章末自测
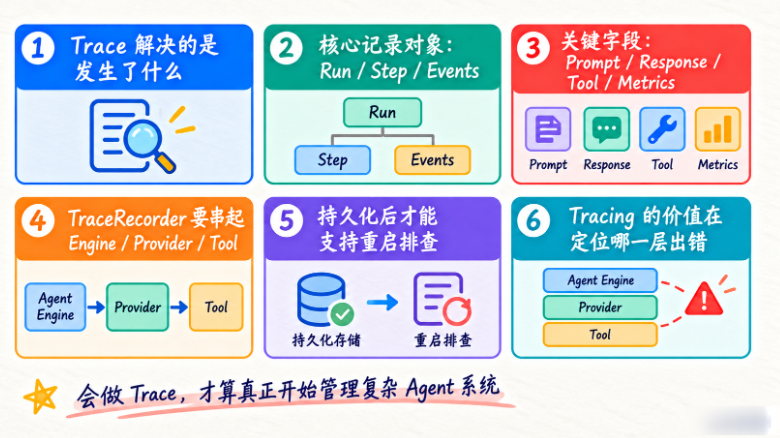
题目 1:Run、Step、Trace、普通日志分别解决什么问题? 请从任务生命周期、过程索引、详细证据和服务运维四个角度解释。 Run 表示一次完整 Agent 任务的生命周期,例如 READY、RUNNING、COMPLE...
Token、成本与耗时监控
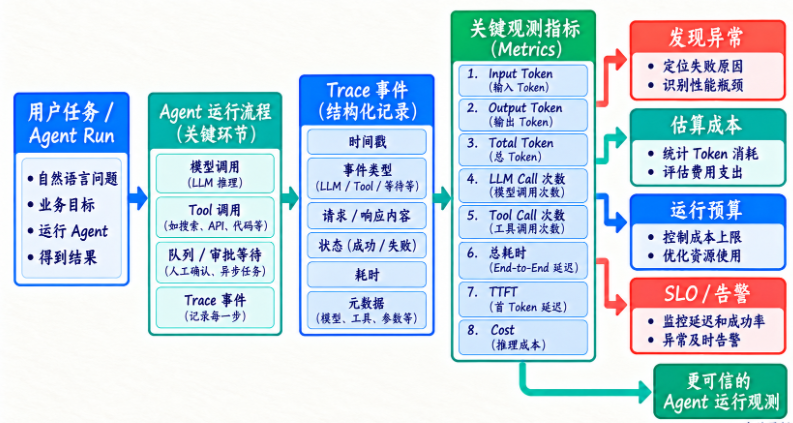
上一节,我们已经用 Trace 把一次 Run 里的 Prompt、模型响应、Tool Call、Observation 和状态变化记录下来。但“能够复盘”还不等于“能够比较”:如果不把这些事件进一步聚合成 Token、Latenc...
Agent Evaluation:Agent 到底好不好怎么评价?
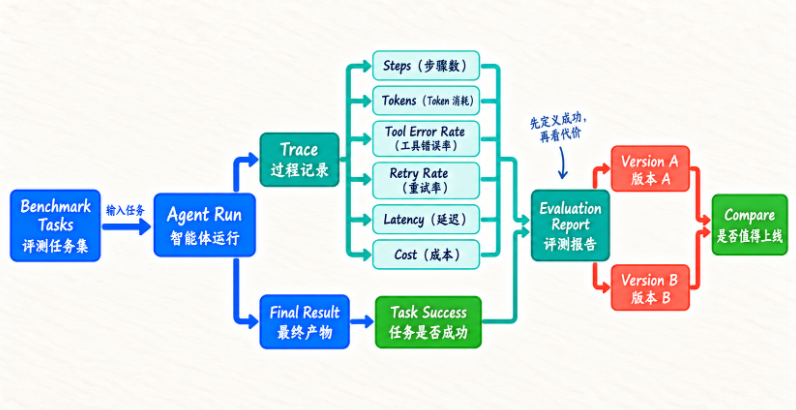
前面两节,我们已经做了两件非常关键的事。 第一件: Tracing 让我们可以完整看到: Run ├─ Step 01 ├─ Step 02 ├─ Step 03 └─ Step 04 并记录: Prompt LLM Response Tool Arguments T...
小节一:先定义“什么叫成功”——没有 Success Criteria,所有 Evaluation 都是空的
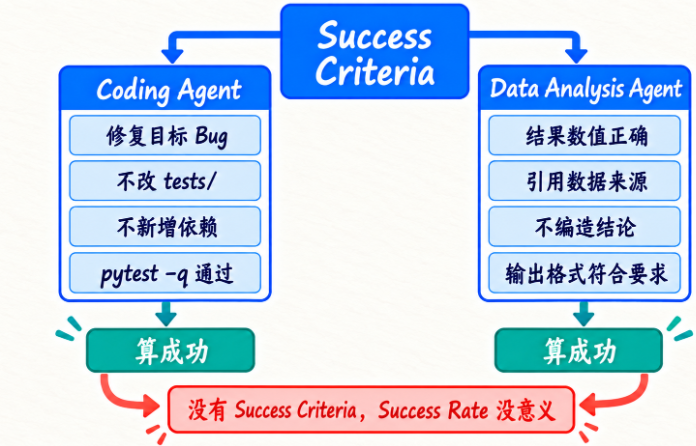
理解成功标准时,先别急着找一个通用的布尔值。修代码和分析数据的验收方式明显不同,但两者都得同时检查结果、限制条件和验证证据。 左侧强调测试与修改约束必须一起满足;右侧强调数据结论需...
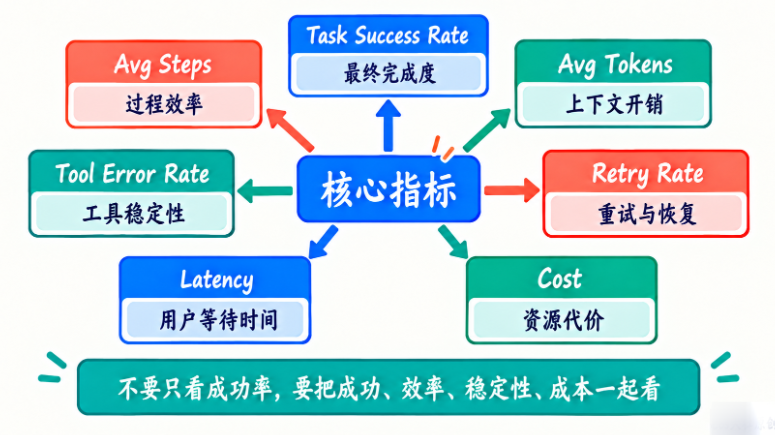
小节二:核心指标到底怎么看——Task Success Rate 只是第一层
这一组指标容易记混,不妨先把它们按用途放在一起。成功率看任务有没有完成;步骤、Token、延迟与成本看完成任务的资源投入;Tool Error 和 Retry 则更接近执行过程的稳定性。 如图所示,没有一...
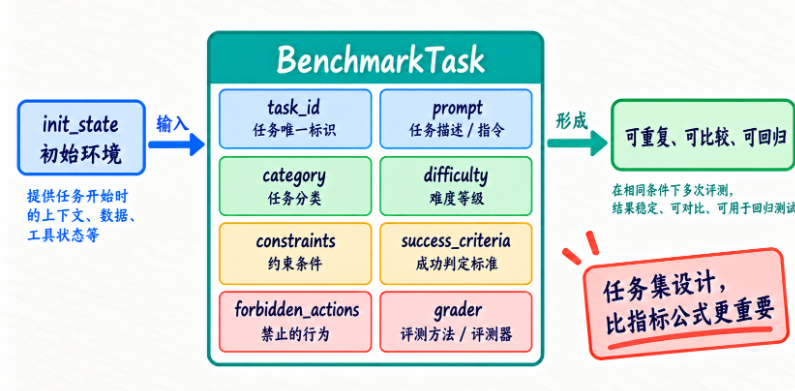
小节三:如何设计自己的 Agent Benchmark——任务集比指标公式更重要
真正决定评测是否可信的,是题目有没有把起点、约束和验收方式说明白。只给一句任务描述,后面即使写出再完整的聚合公式,也没法消除判分歧义。 这张结构图把初始环境、任务字段和重复 Trial 放...
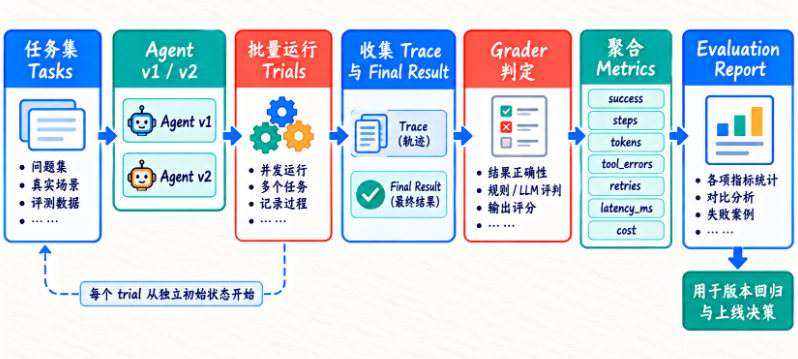
小节四:实现一个最小 EvaluationRunner——批量跑任务,再聚合指标
代码读到这里,可以先用下面的执行链核对各个对象的职责。Runner 不是只循环调用模型,它还要保存 Trace、交给 Grader 判定、聚合指标并形成能够复查的报告。 图中回到任务集的箭头代表下一次独...
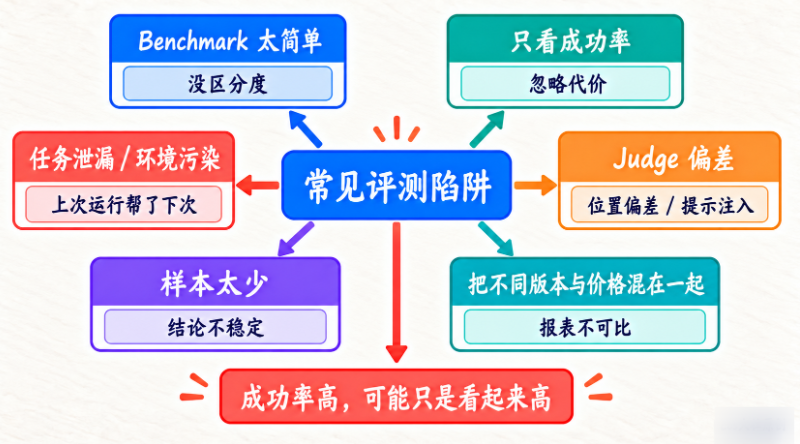
小节五:Agent Evaluation 最容易踩的坑——“成功率高”可能是假象
如果一份评测报告漂亮得过于轻松,可以先沿着下面六个方向排查:题目是否太简单、重复次数是否足够、任务是否泄漏、环境是否隔离,以及统计口径和 Judge 是否可靠。 这些问题不只是让分数稍微偏...
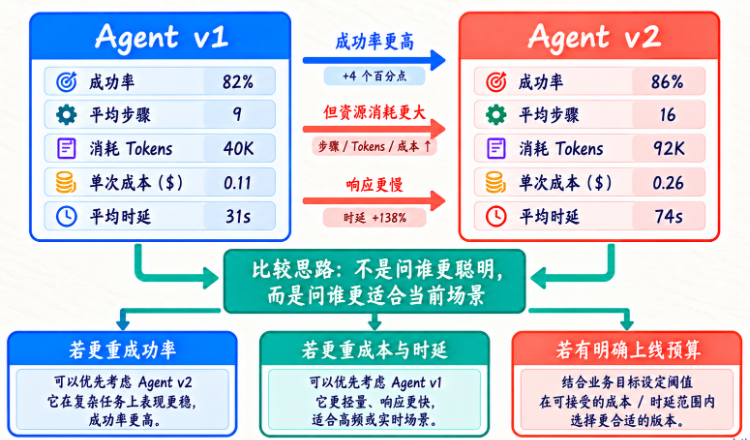
小节六:如何比较两个 Agent 版本——不要问“谁更聪明”,要问“谁更适合这个场景”
比较 v1 和 v2 时,把成功率、步骤、Token、成本与等待时间一起摆出来,会比只说“提升了几个百分点”更清楚。这里的数字是本节设定的演示案例,不是实际线上测量。 图中 v2 的成功率更高,同时...

案例分析一:Coding Agent v2 成功率更高,但为什么不一定值得上线?
场景背景 v1: Success 84% Avg Steps 8 Avg Tokens 30K Cost 0.09 Latency 28s v2: Success 88% Avg Steps 19 Avg Tokens 95K Cost 0.27 Latency 77s 提升: 成功率 +4% 但成本: 3 倍 延迟:...

